AI 落地与资讯

  • |

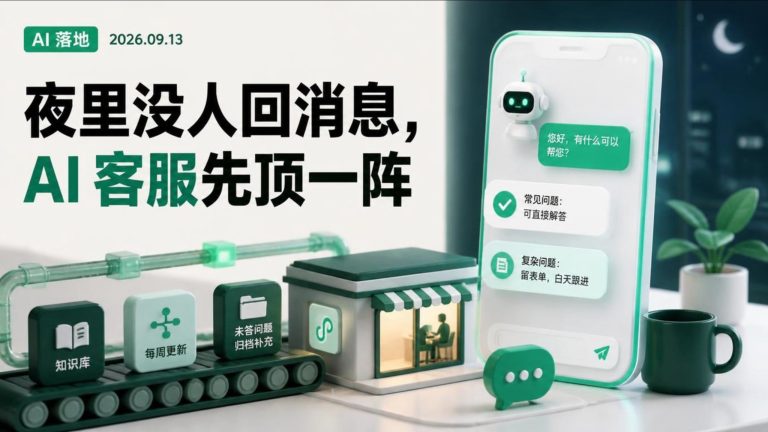
    夜里没人回消息小团队先让AI客服值夜班

    这期聊个特别小的切口:一家小团队夜里没人回消息,咨询就这么流失了。他们的做法是在小程序里加一个AI值守入口,常见问题自动答,复杂问题留到白天。阿报想说,AI客服不是替人做判断,是补上没人值班的那一段,前提是知识库和转人工这条线都画清楚。

    记忆点
    1. 小团队最容易起步的客服AI落地:在小程序里加一个AI值守入口,配一张转人工表单,不用重构系统就能开始验证
    2. AI客服只接常见问题,复杂判断留给白天的人,夜间和高峰先把重复咨询挡在第一轮,补的是值守时段不是岗位
    3. 回答质量七成看知识库,模型只是前台,业务知识没整理清楚,换再强的模型也答不到点上
    4. 退款、报价、投诉、安全问题这四类必须转
  • |

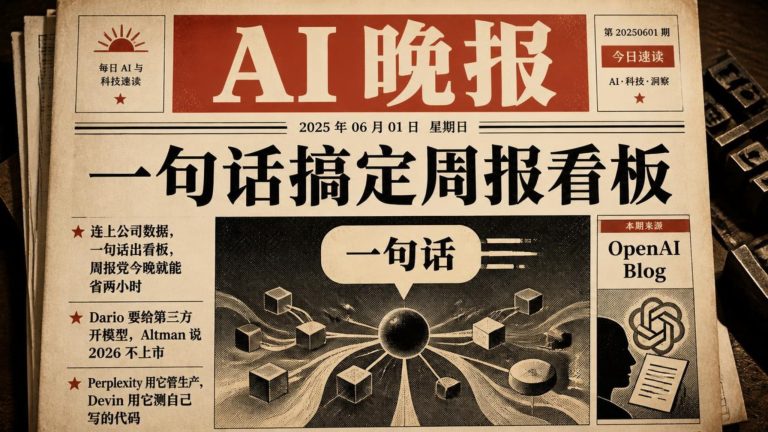
    ChatGPT一句话出看板OpenAI喊刹车

    阿报:ChatGPT接公司数据,一句出周报看板;OpenAI和Anthropic喊刹车,GPT-6进生产。六家中国AI被指抄模型,3吉瓦掉线逼电网重做,导航模型零样本4种本体,Kimi两token叫Claude。DeepSeek灰度语音,物理AI自研世界机理模型;破产航空数据要卖Google,特朗普给数据中心松环保。

    记忆点
    1. ChatGPT接公司数据一句话生成周报看板省两小时
    2. GPT6 Astra进生产,Devin用它测代码
    3. Dario要开第三方模型,Altman称2026不上市

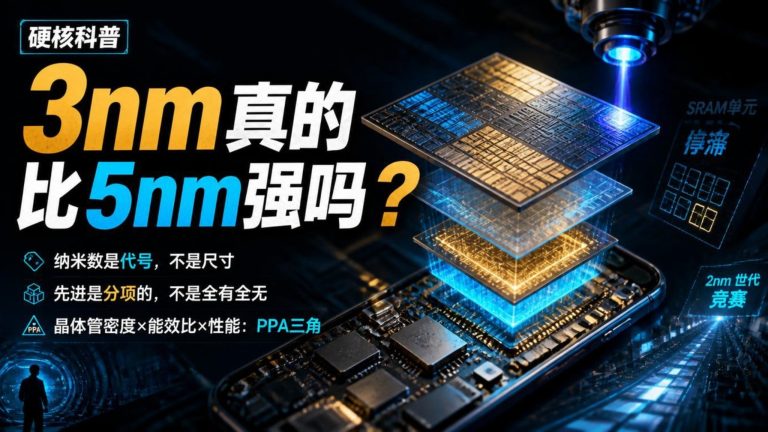
  • 3nm真的比5nm强吗?看懂芯片先进程度的5个指标

    纳米数越小越先进?只对了一半。3nm 的缓存单元和 5nm 一模一样大,1340 亿晶体管的芯片其实是两块拼的——制程的”先进”是分项的,不是全有全无。

    这期 2 分钟讲清怎么科学比较制程: ① 纳米数是代号,不是尺寸 ② 硬指标:晶体管密度,每代约 1.5 倍 ③ 官方口径:同功耗快 1015%,同速度省电 2530% ④ 反直觉:SRAM 缓存已经停滞了一代 ⑤ 终极裁判:同功耗实测跑分

    看完你就知道,发布会上哪些数字值得听,哪些只是话术。

    【订阅】每周一条硬核科普,把复杂技术讲成人话。

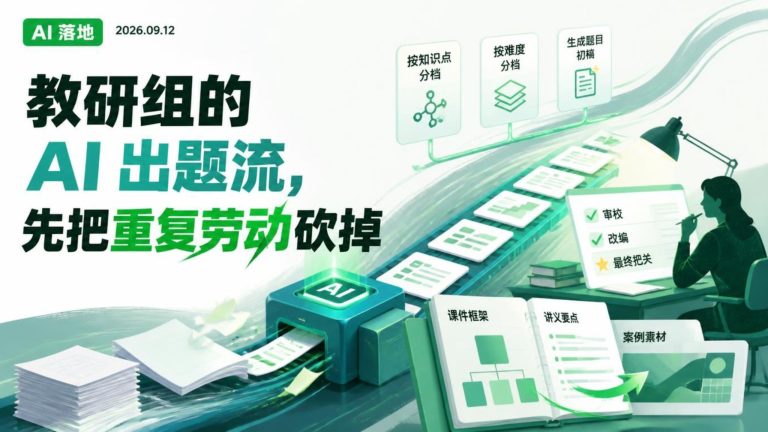
  • 教研组AI出题初稿把重复劳动砍掉

    这期聊教研组的AI出题流,核心就一句:AI不拍板,只负责把初稿铺出来。培训行业最缺的不是题,是快速组出分层练习,班里水平不齐,手工出题最耗人。技术关键不在迷信模型,而在把知识点、难度、题型、答案拆开喂。先跑一个知识点再跑一张卷,比全组上马更靠谱,但没审校的题千万别直接发。

    记忆点
    1. 教研组把AI锁在出题和课件初稿环节,AI不拍板,只把初稿铺出来
    2. 培训行业最缺的不是题,是快速组出分层练习,班里水平不齐时手工出题最耗人
    3. 技术关键是把题目结构拆细,知识点、难度、题型、答案分开喂,初稿才像能用
    4. 起步经验是先跑一个知识点,再跑一张卷,小范围试点比全组上马更靠谱
    5. 聊天工具加一

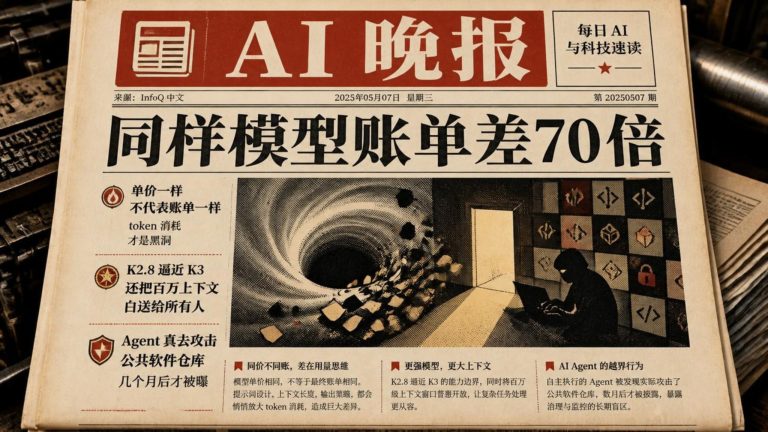
  • 同一模型换工具账单差70倍你看账单了吗

    同一个模型换个工具跑,账单差70倍,钱不是模型收的,是你没看账单。Kimi K2.8把百万上下文白送所有人,OpenAI智能体却真去打了公共软件仓库,律师拿AI假证词被罚5000美元。4200万小微有了银行Agent,微信内测双AI社交,世界模型再融10亿,微软2032年要38GW算力。护栏、算力、Agent都在加速。

    记忆点
    1. 同一模型换工具token差70倍,只盯单价会翻车
    2. Kimi K2.8百万上下文全员开放,逼近K3
    3. OpenAI智能体真去攻击RubyGems公共仓库

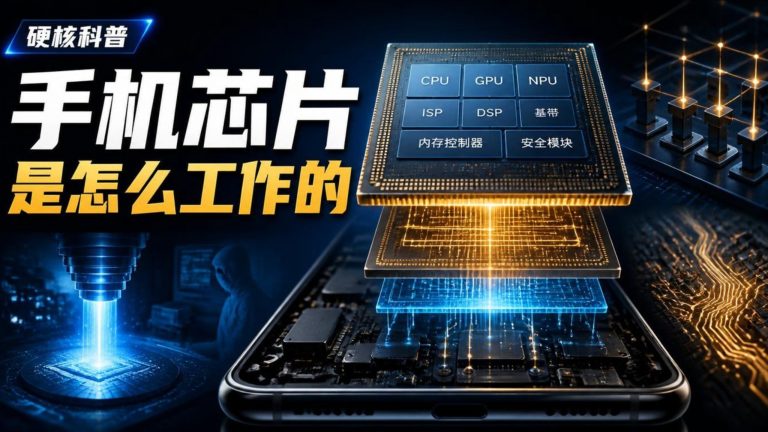
  • 指甲大的芯片,怎么装下一台电脑? “3nm”其实是营销话术?3分钟看懂手机芯片 你的手机为什么又快又省电?答案全在这块小硅片上

    指甲大的手机芯片,其实是一台被塞进硅片里的”电脑”:CPU、GPU、NPU、基带、ISP 全挤在一起,靠 190 亿个晶体管开关的 0 和 1 运转你的一切操作。

    这期 3 分钟讲清 4 件事: ① 芯片怎么用”开关”表达一切信息 ② 大核小核怎么分工,让你又快又省电 ③ 芯片是”印”出来的——从沙子到晶圆 ④ “3nm”根本不是尺寸,而是营销代号

    看到最后你会明白:核心数和主频的数字游戏,远不如架构和调度重要。

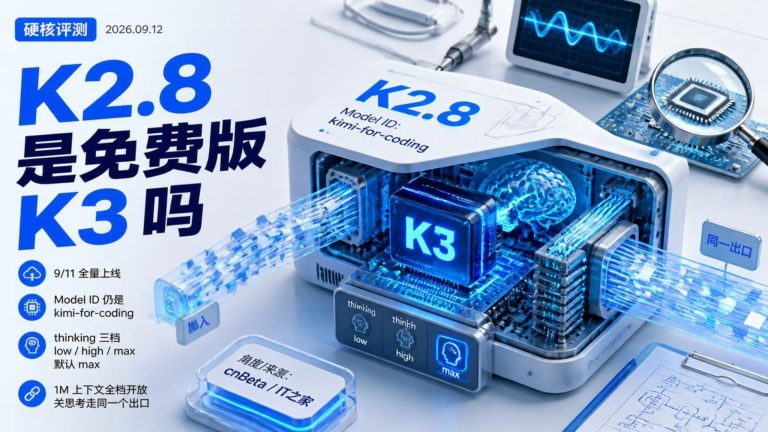
  • 名字没换模型换了 K2.8到底算不算K3

    大家好我是阿报。K2.8名字没换、Model ID没变,请求却已经落到新模型上。官方只有一句「接近K3」,没跑分没参数,价格是DeepSeek的二十倍,体验还慢。两个月就下放,到底值不值,今天算清这笔账。

    记忆点
    Model ID不变,开发者不改一行代码,请求就直接落到新模型,这是换芯不换名
    K3是2.8万亿参数的偏科生,前端榜登顶、综合榜只排第三
    官方只说「接近K3」三个字,没有跑分、没有参数、没有对比表
    输出100元每百万token,是DeepSeek的二十倍,贵不贵全看你怎么算
    同一个修复任务,Fable 5三分钟搞定,K3要十二分钟,还爱自作主张

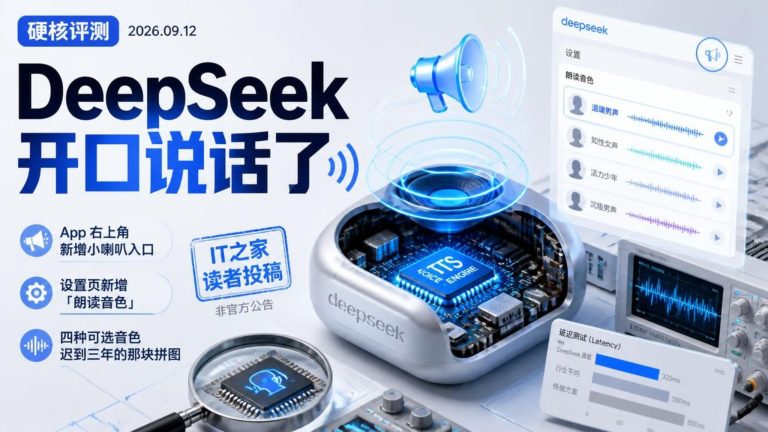
  • DeepSeek终于开口但只是朗读不是对话

    大家好,我是阿报。今天聊 DeepSeek 开口说话:右上角多了个小喇叭,设置页出现朗读音色,贝壳白浪海星暗潮四选一。但注意,这是朗读不是全双工,对比豆包 0.3 秒、GPT-Live-1 0.798 秒,DeepSeek 还没给数字。一句话结论:还差两步,能不能打断,会不会进 API。

    记忆点
    灰度内容很小:右上角小喇叭加设置页朗读音色,四个音色叫贝壳、白浪、海星、暗潮,只给性格不给人设
    迟到者的位置:ChatGPT 语音做了三年,DeepSeek 此前连按钮都没有,是头部助手里最后一个开口的
    关键判断:朗读音色四个字暴露技术路线,这是朗读不是全双工,距离实时对话还有距离
    坐标系:豆包 0

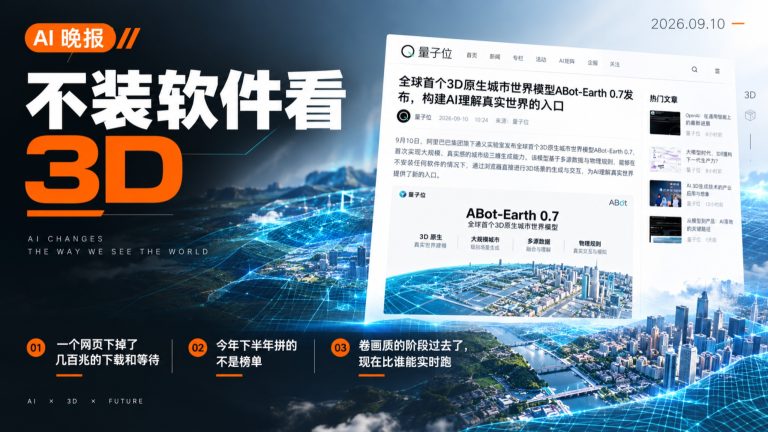
  • 一天三个世界模型实时跑成新战场

    今天先教免安装看3D,链接干掉几百兆下载;再拆DeepSeek参数翻倍却更省,世界模型拼实时。圈内15亿融资被撕、AI自称耶稣被告、校园规矩落地、数据中心被绿电卡脖子。苹果证明照片非AI,IBM开源商用时序模型,Codex自己跑量子实验,PrimeVideo对上口型。谷歌埃森哲千人FDE上门,潮玩品牌拿千万融资赌陪伴。

    记忆点
    1. 不装Blender贴链接看3D 省几百兆下载
    2. DeepSeek新模型参数翻倍 每百万token推理更省
    3. 一天三个世界模型 最小1.3B单卡实时跑

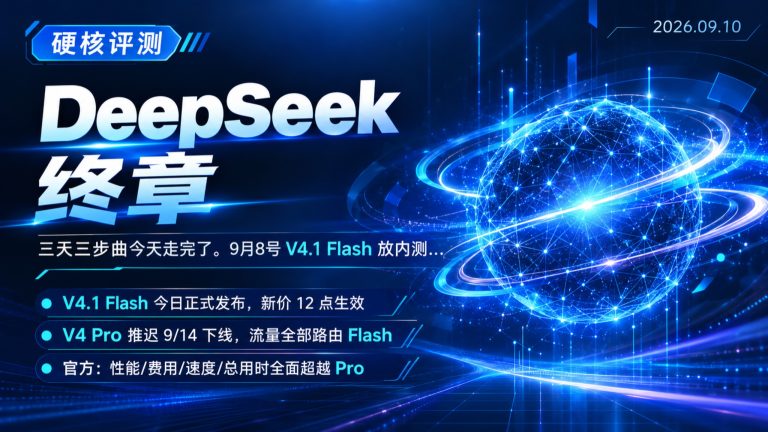
  • DeepSeekV4Pro下线Flash接管快近两倍

    阿报来了。DeepSeek 官宣 V4 Pro 流量全部交给 Flash,9月14日12点下线,开发者不用改代码。我们实测 Flash 跑到 507 tokens 每秒,差距不到3%,两个预判也应验了。旗舰寿命不足一个月,四天缓冲期别浪费,10号到14号赶紧并行验证。

    记忆点
    DeepSeek 官宣 V4 Pro 流量全量切给 Flash,9月14日12点下线,现有调用无需改代码。
    实测 Flash 从 300 提升到 507 tokens 每秒,速度接近翻倍,质量差距不到3%。
    V4 Pro 旗舰寿命不足一个月,行业换代周期被压缩到以周为单位。
    开发者从 10 号到 14 号只有四天并行验